Mediascope: ML-разметка поисковых запросов
Второе место на AI BUSINESS SPb Hackathon: три задачи разметки, эксперименты с простыми и сложными моделями и маршрутизация по уверенности.
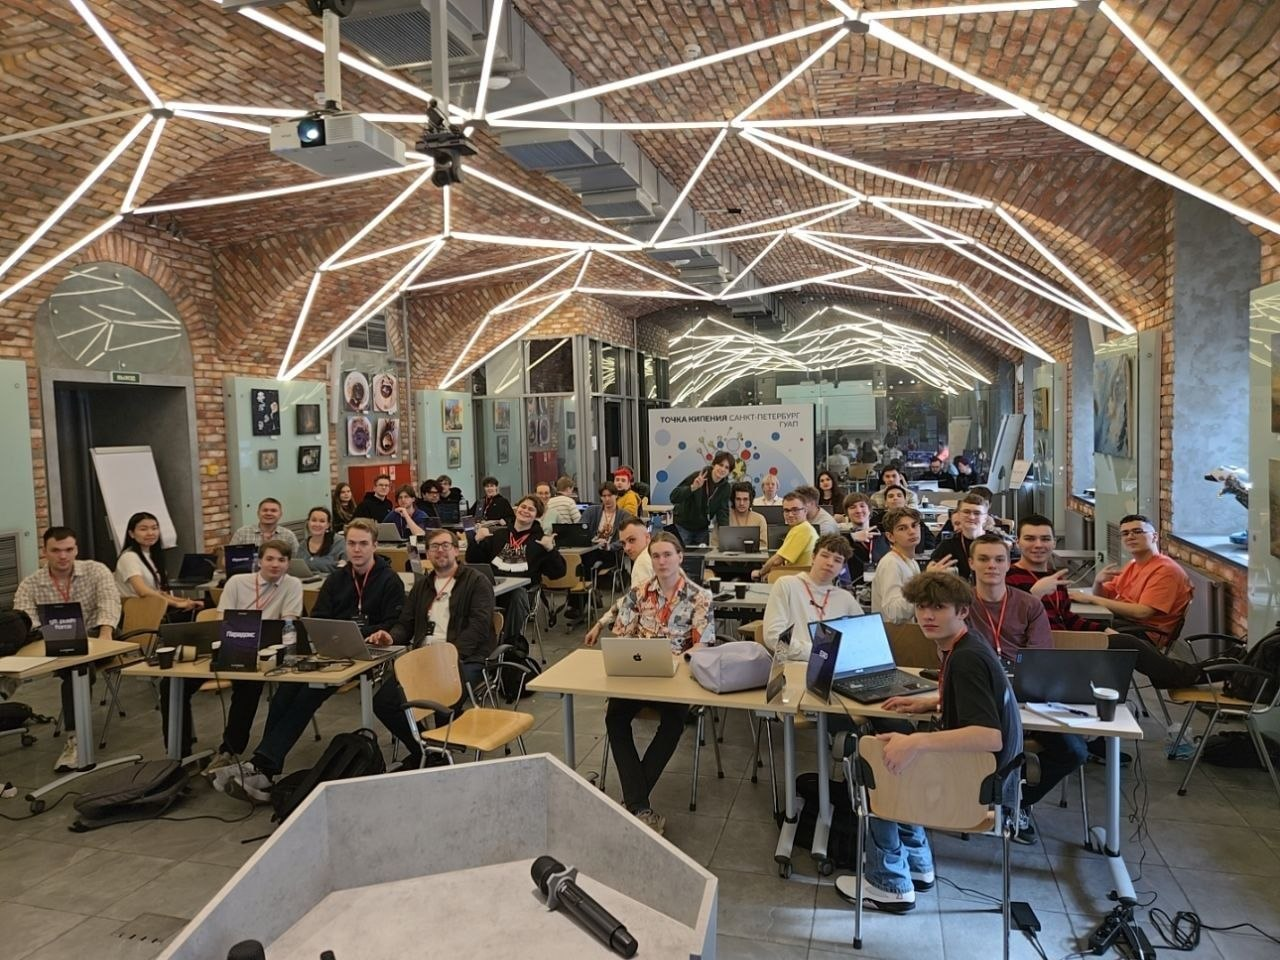
17–18 апреля 2026 года на AI BUSINESS SPb Hackathon в Петербурге наша команда git push force решала кейс Mediascope. Задача — помогать операторам размечать поисковые запросы о профессиональном видеоконтенте. По итогам хакатона заняли второе место.
Что нужно было определить
На вход поступает короткая поисковая формулировка. В ней могут быть опечатки, транслитерация, название франшизы или только общее желание что-то посмотреть. Для каждого запроса требовалось вернуть три признака:
| Признак | Вопрос |
|---|---|
TypeQuery | Относится ли запрос к видеоконтенту? |
ContentType | Это фильм, сериал, мультфильм или другой допустимый тип? |
Title | Какое произведение или франшиза упоминается? |
Например, запрос «1 сезон тьмы» содержит и тип, и название. У «смотреть фильмы 2025 года онлайн» есть видеоинтенция и тип, но нет конкретного произведения.
Целью была помощь операторам: сначала получить предложенную моделью разметку, затем проверять сложные случаи. В задании также предусматривались автономный запуск внутри контура заказчика и пакетная обработка данных. На хакатоне мы делали прототип.
Мой вклад
Участвовал в разработке и обсуждении решения вместе с командой: подготовке данных, экспериментах, проверке результатов и проработке сценария с уверенностью модели. Отдельно отвечал за организацию рабочей среды, доступ к вычислениям, сборку материалов и презентацию.
Работа шла очно. Архитектуру трансформерного варианта и финальную защиту представлял Кирилл, Oxule. Модель, подготовка решения и результат соревнования — командная работа.
Два направления экспериментов
В командном публичном репозитории сохранился вариант на текстовых эмбеддингах. В скрипте обучения используется multilingual-e5-base, поверх которого обучается классификационная голова. Она определяет видеоинтенцию и категорию; поиск по названиям опирается на FAISS. Код обучения.
В коде предсказания названия дополнительно извлекаются через GLiNER, а поиск близких названий служит вторым источником. Реализация сохраняет исходные индексы строк, чтобы пакет ответов корректно сопоставлялся с входными запросами. Код предсказания.
В моём рабочем архиве сохранилось и другое направление: более лёгкий пайплайн на scikit-learn. Он сочетает словные и символьные TF-IDF-признаки, логистическую регрессию и отдельную проверку HasTitle — есть ли в запросе конкретное название. После неё работают словарное сопоставление, проверка границ слов и запасные правила извлечения.
Такое разделение убирает важную ошибку: модель может верно определить видеоинтенцию, но затем приписать произвольное название общему запросу. Проверка наличия названия помогает оставить поле пустым, когда это соответствует задаче.
Схема двух направлений экспериментов:
flowchart LR
    Q["Поисковый запрос"] --> E["E5: текстовые эмбеддинги"]
    E --> C["Классификационная голова"]
    Q --> G["GLiNER и поиск FAISS"]
    Q --> T["Словный и символьный TF-IDF"]
    T --> L["Логистическая регрессия"]
    T --> H["HasTitle: есть ли название"]
    H --> D["Словарь и правила извлечения"]
    C --> O["Видеоинтенция и тип"]
    L --> O
    G --> N["Название или пустое поле"]
    D --> N
Что показала проверка
Для экспериментов в рабочем архиве были отдельно записаны локальная отложенная выборка и результаты отправок в среду соревнования. Некоторые варианты улучшались локально и ухудшались на сервере. Это касалось ансамблей, дополнительных гейтов и части аугментаций: сложность решения сама по себе не гарантировала перенос улучшения.
Внешний LLM не стал надёжным запасным способом для изолированной среды без исходящих запросов. Поэтому проверяли и путь, которому достаточно локальных артефактов и доступных библиотек.
Перед защитой результаты по трём подзадачам были такими:
| Подзадача | Результат |
|---|---|
| Определение видеоконтента | 92% |
| Определение типа | 45% |
| Определение названия | 64% |
Три показателя оценивали разные подзадачи; лидерборд использовал составную метрику.
Как результат помогает оператору
Обсуждали три уровня проверки: высокая уверенность — кандидат на автоматическое принятие, средняя — быстрое подтверждение или исправление, низкая — ручная разметка. Пороги и долю автоматически принятого потока ещё нужно калибровать на реальных данных.
Главный опыт кейса — связать ML-эксперименты с рабочим ограничением: кто проверяет ответ, как обрабатывается отсутствие названия и сможет ли решение выполниться в нужной среде. Наш результат — хакатонный прототип, сохранённый код и второе место.